- किसी तकनीक स्टैक की परतों की पहचान करें और बताएं कि प्रत्येक परत क्या कार्य करती है।
- विभिन्न तकनीकी स्टैक दृष्टिकोणों की तुलना करें और अपने MVP के लिए उपयुक्त दृष्टिकोण चुनें।
- जनरेटिव एआई (LLM) और प्रेडिक्टिव एआई दृष्टिकोणों के बीच अंतर स्पष्ट करें।
- अपनी व्यावसायिक आवश्यकताओं के लिए उपयुक्त एआई मार्ग अपनाएं।
आपके द्वारा चुने गए एआई पथ के आधार पर:
- यदि एलएलएम पथ: तापमान और टोकन सेटिंग्स के साथ अनुकूलित फीडबैक विश्लेषक
- यदि पूर्वानुमान पथ: एक भावना विश्लेषक जो आत्मविश्वास स्कोर के साथ प्रतिक्रिया को वर्गीकृत करता है
- छात्रों ने हितधारकों की प्रतिक्रिया का संकलन और बाजार अनुसंधान पूरा कर लिया है।
- छात्रों को GitHub, Codespaces, localStorage और Gemini API इंटीग्रेशन का अनुभव है।
आपने अपने फाउंडर्स टूलकिट में दो कार्यशील मॉड्यूल बनाए हैं: एक फीडबैक कलेक्टर जो हितधारकों के साक्षात्कारों को संग्रहीत करता है और एक फीडबैक एनालाइजर जो आपके शोध में पैटर्न खोजने के लिए एआई का उपयोग करता है।
अब समय आ गया है कि हम पीछे हटकर यह समझें कि ऐप्स कैसे बनाए जाते हैं और कौन सी तकनीक और एआई दृष्टिकोण आपके समाधान के लिए सबसे उपयुक्त है।
इस इकाई में, हम एआई-संचालित ऐप्स बनाते समय दो महत्वपूर्ण विकल्पों पर चर्चा करेंगे:
- टेक स्टैक: आपके ऐप के लिए टूल्स और प्लेटफॉर्म का संयोजन
- एआई पथ: चाहे आपको टेक्स्ट या इमेज जनरेशन एआई (एलएलएम) की आवश्यकता हो या पैटर्न-आधारित एआई (प्रेडिक्टिव एआई) की।
तकनीकी स्टैक की नींव
आप जिन भी ऐप्स का इस्तेमाल करते हैं – जैसे WhatsApp, YouTube, Instagram और Google – वे सभी एक तकनीकी स्टैक पर आधारित हैं। यह उन तकनीकों का संयोजन है जो मिलकर ऐप को क्रियाशील बनाती हैं।
इसे अपने स्मार्टफोन की तरह समझिए: आपको चीजें देखने के लिए स्क्रीन चाहिए, सोचने के लिए प्रोसेसर चाहिए, फोटो सेव करने के लिए स्टोरेज चाहिए, पावर के लिए बैटरी चाहिए और उपयोगी काम करने के लिए ऐप्स चाहिए। हर हिस्से का अलग काम होता है, लेकिन ये सब मिलकर कुछ उपयोगी बनाते हैं।
एक टेक फाउंडर के रूप में, यह महत्वपूर्ण है कि आपको अपने टेक स्टैक की पूरी समझ हो, यह कैसे काम करता है और आपने इसे क्यों चुना।
प्रत्येक एआई-संचालित एप्लिकेशन में 5 परतें होती हैं:
फ़्रंट एंड
यूजर इंटरफेस (यूआई) – वह सब कुछ जो उपयोगकर्ता अपने ब्राउज़र या फोन में देखता है, क्लिक करता है और जिसके साथ इंटरैक्ट करता है।
उदाहरण:
- वेब: HTML/CSS/Javascript, React, Vue, Angular, Svelte, Next.js
- मोबाइल: रिएक्ट नेटिव, फ्लटर, स्विफ्ट (आईओएस), कोटलिन (एंड्रॉइड)
- स्टाइलिंग: सीएसएस, बूटस्ट्रैप, टेलविंड
बैकएंड
लॉजिक और ब्रेन – सर्वर-साइड कोड जो उपयोगकर्ता के अनुरोधों को संसाधित करता है, एल्गोरिदम चलाता है और डेटाबेस से संवाद करता है।
उदाहरण:
- जावास्क्रिप्ट: Javascript नोड.जेएस
- पायथन: Python जैंगो Django, फास्टएपीआई FastAPI
- जावा: Java स्प्रिंगबूट Springboot
भंडार (Storage)
मेमोरी (The Memory) – जहाँ डेटा रहता है
उदाहरण:
- स्थानीय भंडारण (local storage)
- पोस्टग्रेएसक्यूएल (PostgreSQL)
- MongoDB
- सुपाबेस (Supabase)
- फायरबेस (Firebase)
परिनियोजन प्लेटफ़ॉर्म (Deployment Platform)
बुनियादी ढांचा – वे उपकरण और सेवाएं जो आपके कोड को लेकर आपके ऐप को इंटरनेट पर उपलब्ध कराती हैं।
उदाहरण:
- वर्सेल
- नेटलिफ़ाई
- रेलवे
- गूगल क्लाउड
- ऐप और प्ले स्टोर (मोबाइल ऐप्स)
एआई सेवाएं (AI Services)
इंटेलिजेंस – इंटेलिजेंस सुविधाओं को शक्ति प्रदान करता है
उदाहरण:
- Gemini
- ओपनएआई
- anthropic
- गले लगाने वाला चेहरा
पिछले पाठ में, हमने Notion, Duolingo और Grammarly जैसे ऐप्स के बारे में बात की थी, जो कई फ्रंटएंड, बैकएंड और स्टोरेज विकल्पों के साथ जटिल तकनीकी स्टैक का उपयोग करते हैं। इस जटिलता के लिए व्यापक बुनियादी ढांचे की आवश्यकता होती है क्योंकि ये दुनिया भर में लाखों उपयोगकर्ताओं को सेवा प्रदान करते हैं।
लेकिन आपको अपने एमवीपी या यहां तक कि पोस्ट-एमवीपी के लिए भी उस स्तर की जटिलता की आवश्यकता नहीं है।
सामान्य MVP तकनीकी स्टैक
MVP बनाने का कोई एक "सही" तरीका नहीं है। यहाँ तीन सामान्य तरीके दिए गए हैं:
वैनिला जावास्क्रिप्ट (Vanilla JavaScipt)
तकनीकी भाषाएँ: HTML, CSS, JavaScript, Node.js
रिएक्ट/टाइपस्क्रिप्ट (React/ typescript)
टेक्नोलॉजी: रिएक्ट, टाइपस्क्रिप्ट, वाइट या नेक्स्ट.जेएस
(Python
/Streamlit)
तकनीकें: पायथन, स्ट्रीमलिट, पांडा
आपका फाउंडर्स टूलकिट वैनिला जावास्क्रिप्ट दृष्टिकोण का उपयोग करता है क्योंकि यह सरल है, न्यूनतम सेटअप की आवश्यकता होती है, और आपको उन मूलभूत सिद्धांतों को सिखाता है जो किसी भी स्टैक पर लागू होते हैं।
टेक्नोलॉजी स्टैक चुनते समय, बेहतर होगा कि आप उसी से शुरुआत करें जिसके बारे में आपको जानकारी हो। आपके MVP में कुछ ऐसा होना चाहिए जो काम करे, सीखने में आसान हो और आपके विचार के साथ विकसित हो सके। आप बाद में हमेशा बदलाव कर सकते हैं।
इस गतिविधि में, आप अपने फाउंडर्स टूलकिट में मौजूद टेक स्टैक लेयर्स की पहचान करेंगे और उनकी तुलना गूगल एआई स्टूडियो के बिल्ड मोड से करेंगे, जो एआई-संचालित ऐप्स बनाने के लिए एक अलग दृष्टिकोण अपनाता है।
गतिविधि 1
तकनीकी स्टैक का अन्वेषण करें
अनुमानित समय: 20 मिनट
1. GitHub और अपने Founder's Toolkit रिपॉजिटरी को खोलें।
- GitHub पर जाएं और अपना Founder's Toolkit रेपो खोलें।
- कोड देखने के लिए मुख्य ब्रांच पर जाएं। इसे कोडस्पेस में खोलने की कोई आवश्यकता नहीं है क्योंकि हम केवल फाइलों को देख रहे हैं।
- कोड में अपनी मुख्य फ़ाइलें ढूंढें:
- index.html : आपकी HTML संरचना
- .js एक्सटेंशन वाली फाइलें, जैसे script.js या server.js : यहीं पर आपका जावास्क्रिप्ट कोड होता है।
- CSS फ़ाइलें : ये ऐप के बाहरी स्वरूप को निर्धारित करती हैं।
ध्यान दें कि आपकी फ़ाइल संरचना अलग हो सकती है। उदाहरण के लिए, कोपायलट ने आपकी HTML फ़ाइल में CSS और जावास्क्रिप्ट शामिल किए होंगे। लेकिन आपके प्रोजेक्ट में HTML, CSS और जावास्क्रिप्ट कोड शामिल होंगे।
आपके फाउंडर का टूलकिट संभवतः एक वैनिला जावास्क्रिप्ट स्टैक में है जिसमें निम्नलिखित शामिल हैं:
- फ्रंटएंड: HTML + जावास्क्रिप्ट + CSS
- बैकएंड: Node.js या Python
- संग्रहण: ब्राउज़र लोकल स्टोरेज
- तैनाती: कोडस्पेस सैंडबॉक्स वातावरण
- एआई: जेमिनी एआई
यह एक बेहतरीन शुरुआती बिंदु है क्योंकि यह सीधे किसी भी ब्राउज़र में चलता है, इसके लिए किसी जटिल बिल्ड टूल की आवश्यकता नहीं होती है, और आप इसे आसानी से संशोधित कर सकते हैं।
2. गूगल एआई स्टूडियो का उपयोग करके एक वैकल्पिक दृष्टिकोण देखें
- aistudio.google.com पर जाएं और स्क्रीन के बाईं ओर मेनू में Build विकल्प ढूंढें। उस पर क्लिक करें।
- “जेमिनी के साथ अपने विचारों को साकार करें” के नीचे दिए गए फ़ील्ड में यह प्रॉम्प्ट दर्ज करें। यह वही प्रॉम्प्ट है जिसका उपयोग हमने कोडस्पेस में किया था।
एक सरल ऐप बनाएं जो उद्यमियों को मेरे अधूरे व्यावसायिक विचारों के लिए 2 हितधारकों से प्रतिक्रिया एकत्र करने में मदद करे।
ऐप में निम्नलिखित सुविधाएं होनी चाहिए:
सबसे ऊपर एक शीर्षक: "एआई फाउंडर्स टूलकिट।"
एक उपशीर्षक: "मेरी समस्या पर प्रतिक्रिया एकत्र करना शुरू करें।"
एक टेक्स्ट एरिया जहां मैं अपनी समस्या लिख सकूं
नीचे दिए गए प्रत्येक प्रश्न के लिए उनकी प्रतिक्रिया दर्ज करने हेतु टेक्स्ट क्षेत्र:
क्या यह समस्या उन्हें भी प्रभावित करती है?
उनके अनुसार कौन से पहलू सबसे अधिक महत्वपूर्ण हैं?
आपके मन में कौन से प्रश्न या चिंताएं आती हैं?
इस समस्या के बारे में आपको क्या समझ नहीं आ रहा है?
एक बटन जिस पर "समस्या और प्रतिक्रिया सबमिट करें" लिखा है।
एक आउटपुट क्षेत्र जो समस्या और प्रतिक्रिया प्रदर्शित करता है
- ऐप द्वारा कोड जनरेट होने का इंतजार करें (इसमें कुछ मिनट लग सकते हैं)।
3. AIStudio द्वारा जनरेट की गई फ़ाइलों को देखें
- स्क्रीन के शीर्ष पर स्थित कोड बटन पर क्लिक करके जनरेट की गई फाइलों और कोड को देखें।
यह नीचे दी गई छवि जैसा दिखना चाहिए।
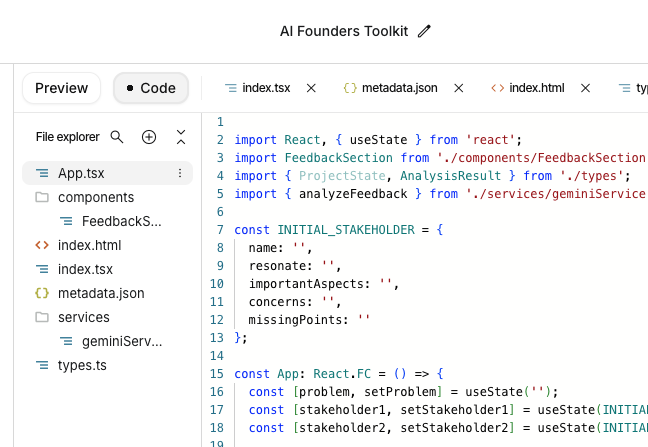
हमारे ऐप में, जेमिनी ने एक कदम आगे बढ़कर, हमारी ओर से बिना किसी अनुरोध के, संश्लेषण और सारांश करने के लिए जेमिनी को एपीआई कॉल को पहले से ही शामिल कर लिया है।
यहां उत्पन्न फाइलों का विवरण दिया गया है, जो कि रिएक्ट तकनीक पर आधारित है।
- .tsx फाइलें टाइपस्क्रिप्ट होती हैं, जो जावास्क्रिप्ट का एक रूप है।
index.html और index.tsx वातावरण स्थापित करें और रिएक्ट एप्लिकेशन को माउंट करें।
App.tsx वैश्विक स्थिति का प्रबंधन करता है, अंतःक्रियाओं को संभालता है और उच्च-स्तरीय लेआउट को प्रस्तुत करता है।
components/FeedbackSection.tsx स्टेकहोल्डर फीडबैक फॉर्म के लिए एक UI कंपोनेंट है।
services/geminiService.ts गूगल की एआई के साथ संवाद करने, प्रॉम्प्ट को परिभाषित करने और मॉडल से संरचित JSON ऑब्जेक्ट वापस करने के लिए कहने का तर्क है ।
types.ts फ़ाइल ऐप में डेटा के लिए TypeScript इंटरफ़ेस को परिभाषित करती है ।
metadata.json में ऐप की जानकारी होती है, जैसे कि एनवायरनमेंट का टाइटल और डिस्क्रिप्शन।
4. दोनों दृष्टिकोणों की तुलना करें।
- AIStudio में कोड टैब खुला रखें।
- एक अलग विंडो में, अपने GitHub Founder's Toolkit रिपॉजिटरी को खोलें और फ़ाइलों को देखने के लिए कोड पर क्लिक करें।
- दोनों ऐप्स के कोड में अंतर का विश्लेषण करें।
गिटहब कोडस्पेस
गूगल एआई स्टूडियो
फ़्रंट एंड
वैनिला जावास्क्रिप्ट (Vanilla JavaScipt)
रिएक्ट + टेलविंड सीएसएस (पूर्व-कॉन्फ़िगर किया गया)
बैकएंड
रिएक्ट + टेलविंड सीएसएस (पूर्व-कॉन्फ़िगर किया गया)
गूगल द्वारा प्रबंधित
भंडार (Storage)
लोकल स्टोरेज (ब्राउज़र)
लोकल स्टोरेज (ब्राउज़र)
तैनाती (हालांकि हम अभी तक वहां नहीं पहुंचे हैं)
बाहरी परिनियोजन प्लेटफ़ॉर्म सेट अप करें और GitHub रिपॉज़िटरी से स्वचालित अपडेट प्राप्त करें
गूगल क्लाउड तक एक क्लिक में पहुंचें
एआई सेवाएं (AI Services)
कोपायलट को भेजे गए आपके प्रॉम्प्ट में निर्दिष्ट अनुसार जेमिनी एपीआई।
जेमिनी एपीआई (एआई स्टूडियो द्वारा स्वचालित रूप से जोड़ा गया)
क्या आपको कोड में कोई और अंतर दिखाई देता है?
5. एआई एकीकरण कोड की तुलना करें
अब आइए विशिष्ट कोड अंतरों पर गौर करें, खासकर एआई एकीकरण कोड पर ध्यान केंद्रित करते हुए।
- दोनों प्लेटफॉर्म पर उन विशिष्ट फाइलों का पता लगाएं जहां एपीआई कॉल किए जाते हैं।
- GitHub रिपॉजिटरी: server.js फ़ाइल खोजें
- Google AI Studio: services/geminiServices.ts जैसी फ़ाइल खोजें
- दोनों फाइलों को खोलें और एपीआई कॉल संरचना को देखें।
दोनों प्लेटफॉर्म:
- प्रॉम्प्ट को परिभाषित करें
- प्रॉम्प्ट भेजें और प्रतिक्रिया प्राप्त करें
- त्रुटियों की जाँच करें
- प्रतिक्रिया को JSON में पार्स करें
आस-पास का कोड अलग दिखता है (जावास्क्रिप्ट बनाम टाइपस्क्रिप्ट), लेकिन मूल एआई एकीकरण पैटर्न समान है।
समस्या निवारण:
यदि आपको अपने कोड में एपीआई कॉल नहीं मिल रहा है: तो अपनी जावास्क्रिप्ट फ़ाइलों में फ़ेच या जेमिनी खोजें या बस कोपायलट और गूगल एआई स्टूडियो कोड असिस्टेंट से इसे खोजने में मदद मांगें।
यदि आपका ऐप Google AI Studio में ठीक से नहीं बना है: तो कोड असिस्टेंट से सहायता मांगें।
आपने अब तक एआई-सहायता प्राप्त कोडिंग वाले दो अलग-अलग प्लेटफॉर्म देखे हैं। ये दोनों अलग-अलग तकनीकी स्टैक तैयार करते हैं जो मूल रूप से एक ही काम करते हैं।
इन प्लेटफॉर्मों के बीच सबसे महत्वपूर्ण अंतर कोड सिंटैक्स नहीं है - बल्कि यह है कि वे आपकी जेमिनी एपीआई कुंजी को कैसे संभालते हैं ।
Google AI Studio आपके API कॉल को अपने सर्वर के माध्यम से संचालित करता है, और बैकएंड पर आपकी API कुंजी को सुरक्षित रूप से जोड़ता है।
आपका ब्राउज़र
↓ ( उपयोगकर्ता इनपुट के साथ अनुरोध भेजता है )
एआई स्टूडियो का फ्रंटएंड ( आपका रिएक्ट कोड )
↓ ( एआई स्टूडियो बैकएंड पर अग्रेषित करता है )
एआई स्टूडियो का सर्वर (गूगल का बुनियादी ढांचा )
↓ ( यह Google के सुरक्षित संग्रहण से आपकी API कुंजी जोड़ता है )
जेमिनी एपीआई
↓ ( प्रतिक्रिया लौटाता है )
एआई स्टूडियो का सर्वर
↓ ( उत्तर आगे भेजा जाता है )
आपका ब्राउज़र ( परिणाम प्रदर्शित करता है )
GitHub Codespaces क्लाइंट-सर्वर आर्किटेक्चर का उपयोग करता है जहाँ आप सब कुछ नियंत्रित करते हैं।
आपका ब्राउज़र ( फ्रंटएंड )
↓ ( आपके बैकएंड को अनुरोध भेजता है )
आपका एक्सप्रेस सर्वर ( आपके द्वारा बनाया गया बैकएंड )
↓ ( .env फ़ाइल से API कुंजी जोड़ता है )
जेमिनी एपीआई
↓ ( प्रतिक्रिया लौटाता है )
आपका एक्सप्रेस सर्वर
↓ ( आगे की प्रतिक्रिया )
आपका ब्राउज़र ( परिणाम प्रदर्शित करता है )
ध्यान दें: यदि आप AI Studio को अपने डेवलपमेंट प्लेटफॉर्म के रूप में उपयोग करते हैं, तो अंततः आपको अपने Gemini API कुंजी की सुरक्षा सुनिश्चित करने के लिए Codespaces के क्लाइंट-सर्वर आर्किटेक्चर को दोहराना होगा। AI Studio की "विशेषताएं" केवल AI Studio के भीतर ही काम करती हैं और अंततः आपको इस प्लेटफॉर्म से बाहर जाना होगा, भले ही केवल अपने MVP को डिप्लॉय करने के लिए ही क्यों न हो।
प्रत्येक प्लेटफॉर्म के लिए कुछ फायदे और नुकसान पर विचार करें।
नियंत्रण
सुविधा
सीखना
रफ़्तार
FLEXIBILITY
सादगी
अपनी तकनीकी संरचना और एआई पथ का चयन करना
अब जब आपको तकनीकी स्टैक की परतों को समझने का कुछ अनुभव हो गया है, तो आपके एमवीपी के लिए दो महत्वपूर्ण निर्णय लेने का समय आ गया है:
- तकनीकी संरचना का चयन: कौन सा विकास दृष्टिकोण आपकी आवश्यकताओं के लिए उपयुक्त है?
- एआई पथ का निर्णय: क्या आपको एलएलएम (जेनरेटिव एआई) या प्रेडिक्टिव एआई का उपयोग करना चाहिए?
ये निर्णय आपके ऐप के निर्माण के तरीके को निर्धारित करते हैं। इसका कोई एक "सही" उत्तर नहीं है और प्रत्येक दृष्टिकोण के अपने फायदे और नुकसान हैं।
नीचे दी गई गतिविधि में आपको एक वर्कशीट पूरी करनी होगी, जिसमें कुछ सवालों के जवाब देने होंगे। ये सवाल आपको अपने प्रोजेक्ट के लिए सही तकनीकी स्टैक और एआई (AI) का चुनाव करने में मदद करेंगे। गलत निर्णय लेने की चिंता न करें। आप बाद में तकनीकी स्टैक बदल सकते हैं। हमारा उद्देश्य अगले कुछ हफ्तों में अपना MVP (मिनिमम वायबल प्रोडक्ट) तैयार करना और उसे उपयोगकर्ताओं तक पहुंचाना है।
एमवीपी मानसिकता
आपका लक्ष्य सबसे सरल तकनीकी ढांचा तैयार करना है जिससे आप अपने विचार का परीक्षण कर सकें। आप अभी लाखों उपयोगकर्ताओं के लिए कोई प्रोडक्शन ऐप नहीं बना रहे हैं। आप कुछ ऐसा बना रहे हैं जिससे आप वास्तविक उपयोगकर्ताओं से जल्दी सीख सकें।
सामान्य नियम:
अगर आपको यह पक्का नहीं पता कि आपको क्या चाहिए, तो चिंता न करें क्योंकि आप बाद में बदलाव कर सकते हैं। असल ऐप्स में ऐसा ही होता है, जहां वे आइडिया से प्रोडक्शन तक पहुंचने के दौरान तकनीकी स्टैक बदलते रहते हैं और समय के साथ उनकी ज़रूरतें भी बदलती रहती हैं।
निर्णय मार्गदर्शिका – तकनीकी स्टैक
अगर आपके एमवीपी को इसकी जरूरत है तो...
विचार करना
एक्सीलरेटर के लिए क्यों?
टेक्स्ट एकत्र करें, परिणाम दिखाएं, बुनियादी लेआउट
वैनिला जावास्क्रिप्ट (जो आपके पास GitHub में है)
सबसे तेज़ "स्मोक टेस्ट"
कई स्क्रीन या जटिल यूआई स्थितियों को संभालें
React/TypeScript (जो आपके पास Google AI Studio में है)
MVP के लिए सबसे अच्छा, डेस्कटॉप और मोबाइल पर ब्राउज़र के माध्यम से काम करता है
इसे न्यूनतम कोड के साथ बहुत जल्दी बनाया जा सकता है।
गूगल एआई स्टूडियो बिल्ड मोड
किसी संकेत/तर्क का तत्काल सत्यापन
मोबाइल ऐप के रूप में चलाएं
रिएक्ट नेटिव / फ्लटर
एक ही कोडबेस जो iOS और Android दोनों पर चलता है
अधिकांश एमवीपी के लिए आपका वर्तमान वैनिला जावास्क्रिप्ट स्टैक पर्याप्त है।
निर्णय मार्गदर्शिका – एआई
अगर आपके एमवीपी को इसकी जरूरत है तो...
विचार करना
पाठ, सारांश या स्पष्टीकरण उत्पन्न करें
एलएलएम
बातचीत करें
एलएलएम
दस्तावेज़ों या ईमेल जैसे असंरचित पाठ का विश्लेषण करें
एलएलएम
वस्तुओं को श्रेणियों में वर्गीकृत करें (जैसे कि कोई पाठ सकारात्मक है या नकारात्मक)।
वर्गीकरण मॉडल के साथ भविष्यसूचक एआई पथ
डेटा से पूर्वानुमान लगाना (मार्केटिंग और सेगमेंटेशन में उपयोग किया जाता है)
भविष्यसूचक एआई पथ
वस्तुओं को स्कोर या रैंक दें
अनुशंसा प्रणालियों के साथ भविष्यसूचक एआई पथ
अधिकांश एमवीपी के लिए, आपके फाउंडर्स टूलकिट में मौजूद प्री-ट्रेन्ड एलएलएम का उपयोग करने का आपका वर्तमान दृष्टिकोण पर्याप्त होना चाहिए।
गतिविधि 2
अपने MVP के लिए तकनीकी स्टैक और AI पथ का चयन करें
अनुमानित समय: 30 मिनट
अब जब आप अपने मौजूदा टूल्स और विकल्पों को समझ चुके हैं, तो अपने टेक स्टैक और एआई दृष्टिकोण को निर्धारित करने के लिए एमवीपी टेक स्टैक डिसीजन वर्कशीट भरें।
एआई पाथ के साथ अभ्यास करें
निम्नलिखित गतिविधियाँ आपको दोनों प्रकार के एआई पथों के साथ अभ्यास करने का अवसर प्रदान करेंगी।
आपको वर्कशीट में अपने एआई पाथ निर्णय के आधार पर केवल एक गतिविधि पूरी करनी होगी।
- यदि आपका एआई पथ एलएलएम है → गतिविधि 3ए पूरी करें
- यदि आपका एआई पथ प्रेडिक्टिव एआई है → गतिविधि 3बी पूरी करें
- यदि आपका एआई पथ प्रेडिक्टिव एआई है और आप अपना खुद का मॉडल बनाने की योजना बना रहे हैं → गतिविधि 3c पूरी करें
गतिविधि 3b एक पूर्व-प्रशिक्षित मॉडल का उपयोग करके एक API को कॉल करती है, जो अधिकांश परियोजनाओं के लिए एक अच्छा विकल्प है, बशर्ते कि आपकी आवश्यकताओं के अनुरूप कोई मॉडल मौजूद हो। अधिकांश परियोजनाओं के लिए यही स्थिति होनी चाहिए।
हम गतिविधि 3सी में आपके स्वयं के मॉडल को प्रशिक्षित करने के बारे में भी चर्चा करेंगे, उन सभी परियोजनाओं के लिए जिन्हें इस मार्ग का अनुसरण करने की आवश्यकता हो सकती है।
एआई एलएलएम की सेटिंग्स और लागत
एलएलएम एपीआई को कॉल करते समय आप कुछ कॉन्फ़िगरेशन सेटिंग्स सेट कर सकते हैं जो इस बात को प्रभावित करती हैं कि एलएलएम आउटपुट कैसे उत्पन्न करता है।
- तापमान: एआई कितना रचनात्मक और कितना सुसंगत है
- टोकन: पाठ की इकाइयाँ (~अंग्रेजी में 3-4 अक्षर); AI इनपुट/आउटपुट को कैसे मापता है
- topK / topP: शब्दावली विविधता को नियंत्रित करता है (आमतौर पर डिफ़ॉल्ट मानों पर छोड़ दें)
अधिकांश उपयोग मामलों के लिए, तापमान और अधिकतम आउटपुट टोकन पर ध्यान केंद्रित करें।
टॉपके और टॉपपी जैसी अन्य सेटिंग्स उन्नत विकल्प हैं जिन्हें आप बाद में देख सकते हैं।
तापमान
तापमान यह नियंत्रित करता है कि मॉडल द्वारा चुने गए शब्द कितने "यादृच्छिक" या "केंद्रित" हैं। इसे "सुरक्षित रहना" और "रचनात्मक जोखिम लेना" के बीच एक डायल की तरह समझें। यह समझने के लिए सबसे महत्वपूर्ण स्थितियों में से एक हो सकता है:
- निम्न तापमान (0.1-0.3): मॉडल लगभग हर बार सबसे संभावित अगले शब्द का चयन करता है। परिणाम सुसंगत और पूर्वानुमानित होते हैं।
- उच्च तापमान (0.7-1.0) : मॉडल कम स्पष्ट शब्दों को चुनने के लिए अधिक इच्छुक होता है। परिणाम अधिक विविध और रचनात्मक होते हैं।
महत्वपूर्ण नोट: अलग-अलग मॉडल अलग-अलग स्केल का उपयोग कर सकते हैं। जेमिनी 0.0-2.0 स्केल का उपयोग करता है, जबकि अधिकांश अन्य मॉडल 0.0-1.0 स्केल का उपयोग करते हैं, इसलिए हमेशा अपने मॉडल के दस्तावेज़ की जांच अवश्य करें।
टोकन
टोकन का उपयोग भाषा अध्ययन प्रणालियों में पाठ को मापने के लिए किया जाता है। अंग्रेजी में एक टोकन लगभग 3-4 अक्षरों का होता है, लेकिन यह भाषा के अनुसार भिन्न होता है।
लगभग 100 शब्द बराबर हैं:
- अंग्रेजी : 75-100 टोकन
- स्पैनिश : 80-100 टोकन
- मंदारिन : 150-200 टोकन
- हिंदी : 120-150 टोकन
टोकन बेहद महत्वपूर्ण हैं, खासकर इसलिए क्योंकि एआई मॉडल प्रदाता अक्सर एपीआई अनुरोधों के लिए टोकन का ही इस्तेमाल करते हैं। इसलिए, टोकन का प्रभावी और कुशल तरीके से उपयोग करना लागत को नियंत्रित करने के लिए आवश्यक है।
अलग-अलग मॉडल अनुरोध में भेजे गए टोकन (इनपुट टोकन) और आउटपुट में भेजे गए टोकन (आउटपुट टोकन) के आधार पर अलग-अलग शुल्क भी लेते हैं।
- इनपुट टोकन: वह सब कुछ जो आप मॉडल को भेजते हैं (आपका प्रॉम्प्ट + संदर्भ)
- आउटपुट टोकन: मॉडल द्वारा उत्पन्न किए गए टोकन
- मूल्य निर्धारण: अधिकांश एपीआई 1,000 टोकन के हिसाब से शुल्क लेते हैं (इनपुट और आउटपुट के लिए अलग-अलग)।
- सीमाएं: मॉडलों में अधिकतम संदर्भ विंडो (सिस्टम प्रॉम्प्ट, इनपुट, आउटपुट सहित टोकन की कुल संख्या) और एपीआई अनुरोध (प्रति अवधि, आमतौर पर प्रति मिनट हम कितने कॉल कर सकते हैं) की सीमाएं होती हैं।
जेमिनी मॉडल के लिए आमतौर पर फ्री टियर काफी उदार होते हैं और उनमें बहुत बड़ी कॉन्टेक्स्ट विंडो होती हैं जो प्रोडक्शन-लेवल ऐप्स के लिए भी पर्याप्त से अधिक होती हैं, लेकिन आपके एमवीपी के लिए तो पर्याप्त होनी ही चाहिए।
एमवीपी टोकन का सामान्य नियम
संक्षिप्त सुझाव → सस्ता, तेज़, अधिक विश्वसनीय
संक्षिप्त परिणाम → परीक्षण और तुलना करना आसान
कम एपीआई कॉल → डीबग करना आसान
अपने एमवीपी के लिए, निम्नलिखित लक्ष्य रखें:
- उपयोगकर्ता की प्रत्येक क्रिया के लिए 1-2 एआई कॉल
- जब तक अत्यंत आवश्यक न हो, आउटपुट लगभग 300 शब्दों से कम का होना चाहिए।
उदाहरण: समान फ़ीचर, अलग-अलग टोकन लागत
उच्च लागत वाला संकेत:
"सभी साक्षात्कार प्रतिलेखों का विश्लेषण करें और उपयोगकर्ता द्वारा सबमिट पर क्लिक करने पर हर बार एक विस्तृत 2-पृष्ठ की रिपोर्ट तैयार करें।"
कम लागत वाला प्रॉम्प्ट:
"प्रतिक्रिया का विश्लेषण करें और 3 प्रमुख निष्कर्ष और 1 खुला प्रश्न प्रस्तुत करें।"
दूसरा संस्करण सस्ता, तेज, मूल्यांकन में आसान है और उपयोगकर्ताओं के लिए अभी भी उपयोगी है।
एआई एपीआई की लागतों के बारे में ज्यादा चिंता न करें, क्योंकि आप मुफ्त संस्करण में भी बहुत कुछ चला सकते हैं।
यहां फाउंडर्स टूलकिट में मौजूद आइडिया इवैल्यूएटर के साथ लागत का एक उदाहरण दिया गया है।
इनपुट टोकन:
- सिस्टम प्रॉम्प्ट: ~200 टोकन
- 3 समाधान, विवरण सहित: प्रत्येक में लगभग 500 टोकन = कुल 1,500 टोकन
- कुल इनपुट ~1,700 टोकन
आउटपुट टोकन:
- विश्लेषण और अनुशंसा: लगभग 800 टोकन
प्रत्येक विश्लेषण के लिए कुल: लगभग 2,500 टोकन
जेमिनी फ्लैश के साथ कीमत : लगभग $0.0009 (1 सेंट से भी कम)
प्रति माह 100 उपयोगकर्ताओं द्वारा प्रत्येक का 3 बार विश्लेषण:
- – 300 विश्लेषण × 2,500 टोकन = 750,000 टोकन
- लागत: लगभग $0.27 प्रति माह
यह फ्री टियर की सीमाओं के भीतर ही है।
गतिविधि 3ए
एआई पथ - एलएलएम
अनुमानित समय: 30 मिनट
यदि आपने अपनी वर्कशीट में LLM AI पाथ चुना है, तो इस गतिविधि को पूरा करें।
अपने फाउंडर्स टूलकिट में, आपने जेमिनी एपीआई का उपयोग करके एक फीडबैक एनालाइज़र बनाया था। इस गतिविधि में, आप आउटपुट की गुणवत्ता में सुधार करने के लिए अपने फीडबैक एनालाइज़र की एआई सेटिंग्स को अनुकूलित करेंगे। आप तापमान और टोकन सेटिंग्स का उपयोग करके एलएलएम व्यवहार को नियंत्रित करना सीखेंगे। इन दोनों को कॉन्फ़िगर करना जानना उत्पादन-गुणवत्ता वाली एआई सुविधाओं के निर्माण के लिए आवश्यक ज्ञान है।
1. GitHub कोडस्पेस में नई ब्रांच बनाएं
- GitHub पर जाएं और अपने Founder's Toolkit रिपॉजिटरी को खोलें।
- main ब्रांच से एक नई ब्रांच बनाएं और उसका नाम llm-customization रखें।
- पिछली गतिविधियों से अपने मौजूदा कोडस्पेस को खोलें।
- अपने मौजूदा कोडस्पेस में नई ब्रांच चेकआउट करें। इससे आपके ऐप के पिछले निष्पादनों से localStorage सुरक्षित रहेगा।
- स्क्रीन के निचले भाग में स्थित टर्मिनल विंडो में, अलग-अलग पंक्तियों में टाइप करें:
git checkout main
git pull origin main
git checkout -b llm-customization
- स्क्रीन के निचले भाग में स्थित टर्मिनल विंडो में, अलग-अलग पंक्तियों में टाइप करें:
2. एआई एकीकरण कोड खोजें
- वह जावास्क्रिप्ट फ़ाइल ढूंढें जो एआई कॉल करती है (संभवतः server.js)।
- कोड में उस हिस्से को ढूंढें जहां आप जेमिनी एलएलएम को एपीआई कॉल कर रहे हैं, जिसमें सिस्टम इंस्ट्रक्शन (एलएलएम इंस्ट्रक्शन) और एलएलएम कॉन्फ़िगरेशन सेटिंग्स शामिल होनी चाहिए।
आपको कुछ इस तरह का ढूंढना चाहिए:
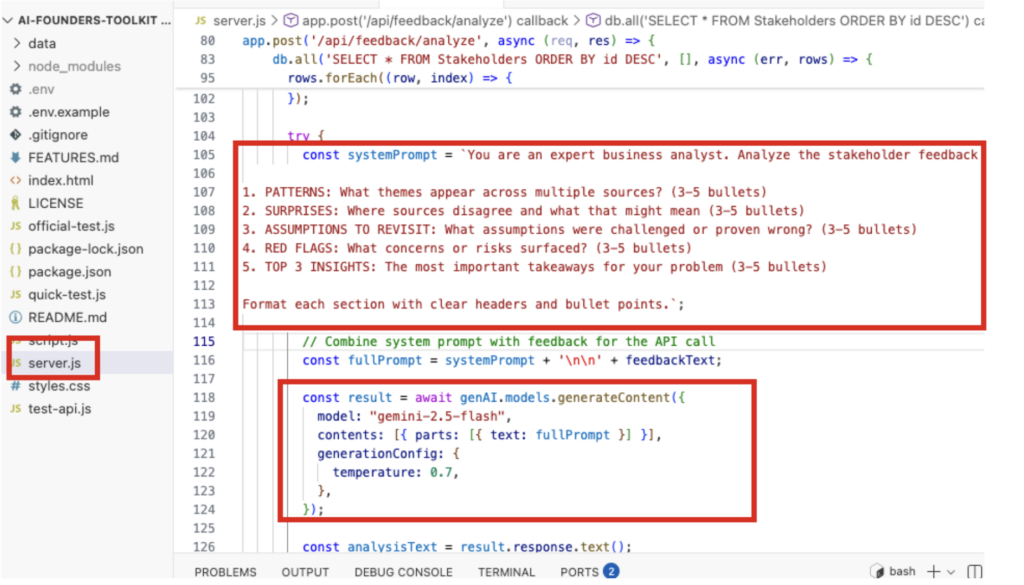
const result कोड में generationConfig सेटिंग देखें। हमारे मामले में, Copilot द्वारा केवल तापमान सेटिंग को स्वचालित रूप से कॉन्फ़िगर किया गया था। Gemini जैसे कई LLM में, कॉन्फ़िगरेशन पैरामीटर प्रदान न किए जाने पर डिफ़ॉल्ट सेटिंग्स का उपयोग किया जाता है। हालाँकि, हम तापमान और maxOutputTokens को जोड़ना एक अच्छा अभ्यास मानते हैं।
3. एलएलएम कॉन्फ़िगरेशन कोड जोड़ें
- कॉन्फ़िगरेशन पैरामीटर सेट करने के लिए कोड को निम्नानुसार अपडेट करें:
- तापमान: 0.8
- अधिकतम आउटपुट टोकन: 1024
हमारा कोड कुछ इस तरह दिखता है:
					generationConfig: {
  temperature: 0.8,
  maxOutputTokens: 1024,
}
- server.js में जांच लें कि कोड सही दिख रहा है या नहीं।
4. एकाधिक परीक्षण चलाएँ
इसके प्रभाव को समझने के लिए आइए विभिन्न परीक्षण करें।
- वर्तमान सेटिंग्स के साथ फीडबैक एनालाइजर चलाएं।
- हर बार जब आप एनालाइजर चलाते हैं तो परिणामों को एक अलग दस्तावेज़ में कॉपी और पेस्ट करें ताकि आप प्रत्येक आउटपुट की तुलना कर सकें।
- इसे समान कॉन्फ़िगरेशन सेटिंग्स के साथ दोबारा चलाएँ।
- आउटपुट की तुलना करें। वे काफी हद तक समान दिखने चाहिए।
- तापमान को 0.2 (क्रिएटिव) पर सेट करें और फिर से चलाएं।
- परिणामों की तुलना करें। परिणाम अधिक विविध होने चाहिए।
- दोबारा कोशिश करें, इस बार maxOutputTokens को किसी छोटी संख्या में बदलें, जैसे कि 300।
- लंबे उत्तरों से प्राप्त परिणामों की तुलना करें।
5. अपना आदर्श तापमान ज्ञात करें
तय करना:
आपके फीडबैक एनालाइजर के लिए कौन सा तापमान सबसे अच्छा काम करता है?
- यदि आप सुसंगत और विश्वसनीय विश्लेषण चाहते हैं, तो 0.3-0.4 का उपयोग करें।
- अधिक रचनात्मक अंतर्दृष्टि के लिए 0.6-0.7 का उपयोग करें।
अपने कोड को अपने पसंदीदा तापमान के अनुसार अपडेट करें।
6. अपने बदलावों को कमिट, पुश और मर्ज करें
- अपने कोडस्पेस में अपने बदलावों को कमिट करें।
- GitHub पर जाएं, एक पुल रिक्वेस्ट बनाएं और बदलावों को मुख्य ब्रांच में मर्ज करें।
- आप अपनी ब्रांच को डिलीट कर सकते हैं, लेकिन अपना कोडस्पेस रख सकते हैं।
अब आप एलएलएम के व्यवहार को नियंत्रित करने वाली प्रमुख सेटिंग्स को समझ गए हैं। जब आप अपना खुद का पूर्ण एमवीपी बनाएंगे, तो आप इन अवधारणाओं को लागू करके ऐसी एआई सुविधाओं को डिज़ाइन करेंगे जो आपके उपयोगकर्ताओं की आवश्यकताओं के अनुरूप व्यवहार करें।
यदि आप अपने ऐप में किसी भी प्रकार की प्रेडिक्टिव एआई का उपयोग नहीं कर रहे हैं, तो आप सीधे रिफ्लेक्शन सेक्शन पर जा सकते हैं।
पूर्व-प्रशिक्षित मशीन लर्निंग मॉडल
एक प्री-ट्रेन्ड मॉडल वह मॉडल होता है जिसे किसी और ने पहले से ही बड़ी मात्रा में डेटा पर प्रशिक्षित किया होता है। आप इसे अपना खुद का प्रशिक्षण डेटा एकत्र किए बिना उपयोग कर सकते हैं। किसी मॉडल का उपयोग करके नए डेटा पर पूर्वानुमान लगाना इन्फरेंस कहलाता है। इसलिए, किसी चीज़ का पूर्वानुमान लगाने के लिए API अनुरोध करना एक इन्फरेंस है।
लागत संबंधी विचार: भविष्यसूचक एआई का मूल्य निर्धारण
प्रेडिक्टिव एआई एपीआई कॉल के हिसाब से शुल्क लेता है या इसमें एक बार का प्रशिक्षण शुल्क लगता है। वर्गीकरण कार्यों के लिए प्रेडिक्टिव एआई, एलएलएम की तुलना में काफी सस्ता है। इस एक्सेलेरेटर में सभी एमवीपी के लिए निःशुल्क टियर पर्याप्त हैं।
प्रेडिक्टिव एआई का प्राइसिंग मॉडल एलएलएम से अलग है:
इस गतिविधि में हम जिस प्लेटफॉर्म का उपयोग करेंगे, 'हगिंग फेस' , वह प्रति दिन 1000-2000 (मॉडल के आधार पर) मुफ्त एपीआई अनुरोध प्रदान करता है।
प्रशिक्षण की लागत एक बार ही लगती है, और अनुमान लगाना (भविष्यवाणी करना) एलएलएम की तुलना में बड़े पैमाने पर सस्ता होता है। हालांकि एआई प्रशिक्षण और भविष्यवाणी में जीपीयू (ग्राफिक प्रोसेसिंग यूनिट) की लागत एक बड़ा कारक है, पूर्व-प्रशिक्षित मॉडलों को जीपीयू लागत की आवश्यकता नहीं होती है। लागत प्रशिक्षण में ही आती है, और उसका भुगतान किसी और द्वारा किया जाता है।
यह तालिका आपको पूर्व-प्रशिक्षित मॉडल का उपयोग करके वर्गीकरण/भविष्यवाणी की लागत और भविष्यवाणी के लिए एलएलएम का उपयोग करने की लागत का अंदाजा देती है।
पहलू
भविष्यसूचक एआई
एलएलएम (तुलना के लिए)
मूल्य निर्धारण मॉडल
प्रति एपीआई कॉल या एक निश्चित मासिक शुल्क
प्रति टोकन (इनपुट + आउटपुट)
प्रशिक्षण लागत
मुफ़्त (गले लगाने वाला चेहरा, सिखाने योग्य मशीन)
प्रत्येक वर्गीकरण के लिए लगभग $0.0001
अनुमान लागत
मुफ़्त (1K/दिन) या $9/माह असीमित
लागू नहीं (पूर्व-प्रशिक्षित)
जीपीयू की आवश्यकता है?
नहीं (प्रदाता इसे संभालता है)
नहीं (प्रदाता इसे संभालता है)
बड़े पैमाने पर (10,000 प्रति दिन)
9 डॉलर प्रति माह (निश्चित दर)
लगभग 30-40 डॉलर प्रति माह (परिवर्तनीय)
भावना विश्लेषण मॉडल (Sentiment Analysis Model)
गतिविधि 3बी के लिए, हम ( cardiffnlp/twitter-roberta-base-sentiment-latest ) नामक मॉडल का उपयोग करेंगे, जिसे 124 मिलियन ट्वीट्स पर प्रशिक्षित किया गया है। यह टेक्स्ट को तीन श्रेणियों में वर्गीकृत करता है:
- सकारात्मक: खुश, उत्साहित, संतुष्ट
- नकारात्मक: क्रोधित, उदास, निराश
- तटस्थ: तथ्यात्मक, न सकारात्मक न नकारात्मक
ट्विटर टेक्स्ट पर आधारित एआई मॉडल भावना विश्लेषण में बहुत प्रभावी होते हैं क्योंकि यह वास्तविक उपयोगकर्ता की भाषा पर आधारित होता है और बड़े पैमाने पर काम करता है।
कई ग्राहक सहायता कंपनियां चैटबॉट जैसे अपने ऐप्स को बेहतर बनाने या ग्राहक अनुभव को सुधारने के लिए ग्राहकों की भावनाओं का विश्लेषण करती हैं। यह आपके हितधारकों की प्रतिक्रिया में भावनाओं का विश्लेषण करने का एक अच्छा तरीका हो सकता है।
गतिविधि 3बी
एआई पथ - भविष्यसूचक (भावना विश्लेषण)
अनुमानित समय: 40 मिनट
यदि आपने अपनी वर्कशीट में प्रेडिक्टिव एआई पाथ चुना है, तो इस गतिविधि को पूरा करें।
इस गतिविधि में, हम जेमिनी मॉडल का उपयोग करके एपीआई कॉल करने के समान कोड पैटर्न का उपयोग करते हुए, एक पूर्व-प्रशिक्षित मॉडल का उपयोग करके आपके फाउंडर्स टूलकिट में एक भावना विश्लेषक जोड़ेंगे।
1. हगिंग फेस अकाउंट बनाएं और एपीआई टोकन बनाएं।
- huggingface.co पर जाएं और एक निःशुल्क खाता बनाएं (यदि आपके पास पहले से कोई खाता नहीं है)।
- अपनी प्रोफ़ाइल पर क्लिक करें → सेटिंग्स → एक्सेस टोकन
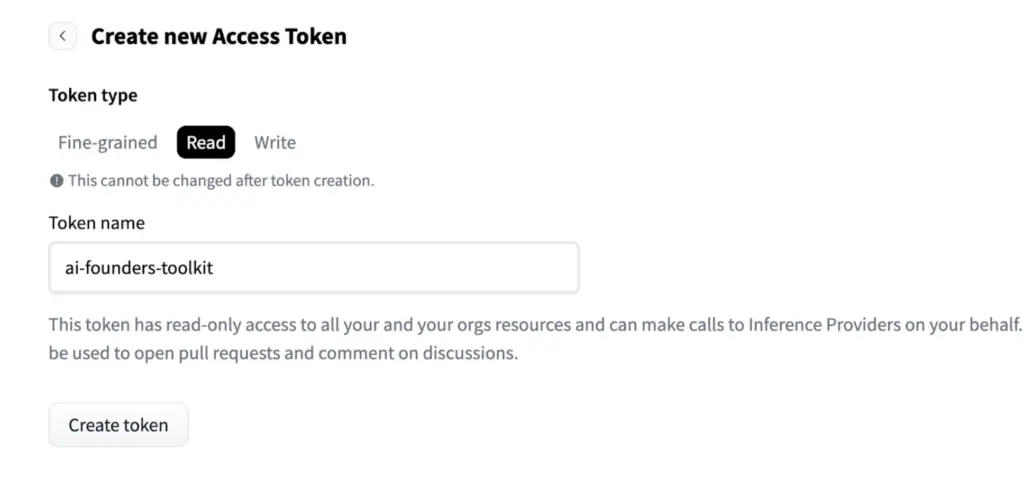
- नया टोकन बनाने के लिए क्लिक करें, टोकन प्रकार "रीड" चुनें और इसे एक उपयुक्त नाम दें।
- टोकन का मान कॉपी करें और इसे सुरक्षित रूप से सहेजें।
2. GitHub कोडस्पेस में नई ब्रांच बनाएं
- GitHub पर जाएं और अपने Founder's Toolkit रिपॉजिटरी को खोलें।
- main ब्रांच से एक नई ब्रांच बनाएं और उसका नाम sentiment-analysis रखें।
- पिछली गतिविधियों से अपने मौजूदा कोडस्पेस को खोलें।
- अपने मौजूदा कोडस्पेस में नई ब्रांच चेकआउट करें। इससे आपके ऐप के पिछले निष्पादनों से localStorage सुरक्षित रहेगा।
- स्क्रीन के निचले भाग में स्थित टर्मिनल विंडो में, अलग-अलग पंक्तियों में टाइप करें:
git checkout main
git pull origin main
git checkout -b sentiment-analysis
- स्क्रीन के निचले भाग में स्थित टर्मिनल विंडो में, अलग-अलग पंक्तियों में टाइप करें:
3. टोकन को अपने प्रोजेक्ट में जोड़ें
अपने कोडस्पेस एनवायरनमेंट में, टोकन को अपने एनवायरनमेंट में जोड़ें।
- अपनी .env फ़ाइल में यह पंक्ति जोड़ें: HUGGINGFACE_API_KEY=your_token_here
- अपना टोकन ऊपर दिए गए कोड में पेस्ट करें।
एक अन्य विधि
कोडस्पेस में कोडस्पेस सीक्रेट्स नामक एक सुविधा है जिसका उपयोग प्रोजेक्ट विकास के दौरान एपीआई कुंजी जैसी चीजों को सुरक्षित रखने के लिए किया जाता है।
- GitHub पर अपने रिपॉजिटरी में जाएं।
- सेटिंग्स खोलने के लिए गियर आइकन पर क्लिक करें।
- बाईं ओर के मेनू में, सीक्रेट्स एंड वेरिएबल्स पर क्लिक करें, फिर कोडस्पेस पर क्लिक करें।
- HUGGINGFACE_API_KEY के लिए अपने टोकन मान के साथ एक नया सीक्रेट जोड़ें।
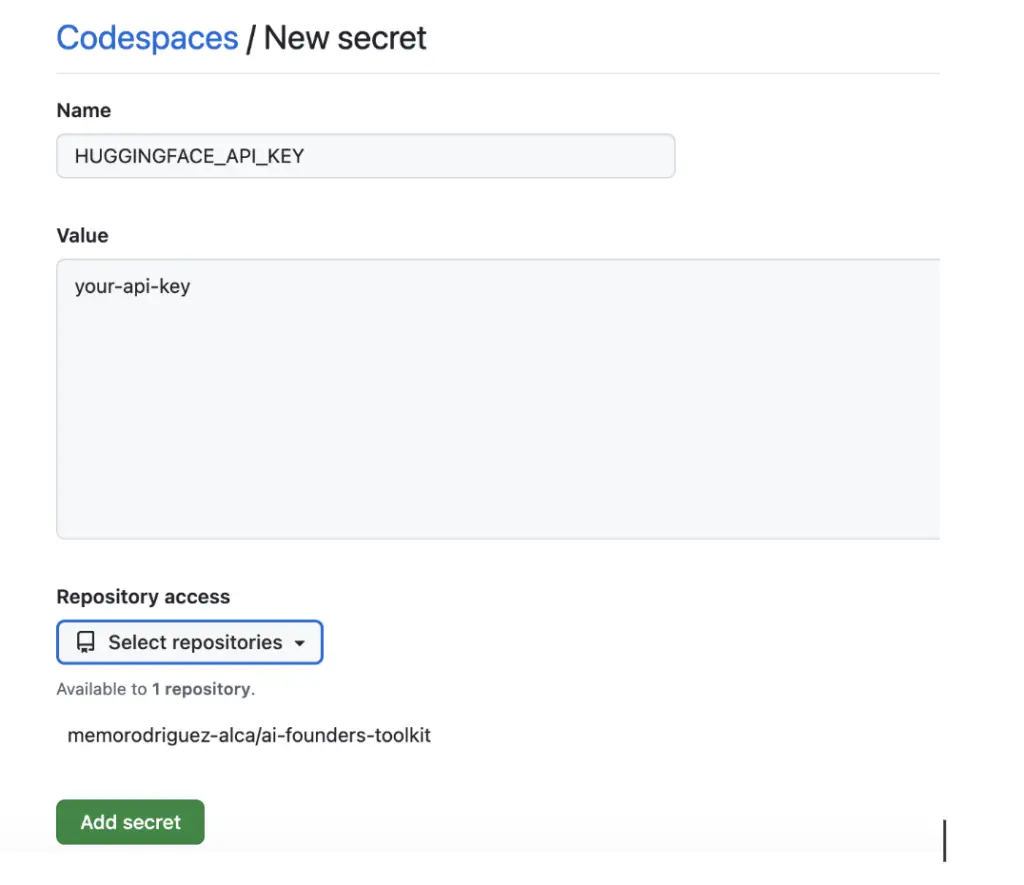
इस गतिविधि के लिए, हम .env फ़ाइल में कुंजी जोड़ने तक ही सीमित रहेंगे। हालाँकि, आप अपने ऐप की सुरक्षा बढ़ाने के लिए आगे की इकाइयों में GitHub Secrets के बारे में और जानेंगे।
4. भावना विश्लेषण कोड जोड़ें
इस प्रॉम्प्ट को पेस्ट करके कोपायलट से इस फीचर को जोड़ने का अनुरोध करें।
हितधारकों की प्रतिक्रिया के लिए पूर्व-प्रशिक्षित भावना विश्लेषण मॉडल का उपयोग करके भावना विश्लेषण को शामिल करें।
- “Sentiment Analyzer” नाम से एक नया टैब बनाएं।
- एक टेक्स्ट इनपुट जोड़ें जहां उपयोगकर्ता फीडबैक टेक्स्ट टाइप या पेस्ट कर सकें।
- "भावना का विश्लेषण करें" नामक एक बटन जोड़ें
- क्लिक करने पर, हगिंग फेस इन्फरेंस एपीआई को कॉल करें:
“ https://router.huggingface.co/hf-inference/models/cardiffnlp/twitter-roberta-base-sentiment-latest “
- परिणाम प्रदर्शित करें:
– लेबल लगाएं (सकारात्मक, नकारात्मक या तटस्थ)
– आत्मविश्वास स्कोर प्रतिशत के रूप में (स्कोर को 100 से गुणा करें)
मैंने HUGGINGFACE_API_KEY को अपनी .env फ़ाइल में जोड़ दिया है।
5. आवश्यक पैकेज इंस्टॉल करें और चलाएं
- पैकेज इंस्टॉल करने के लिए कोपायलट के सभी निर्देशों का पालन करें।
- अपने ऐप को शुरू करने के लिए टर्मिनल विंडो में npm start टाइप करें।
6. हितधारकों की प्रतिक्रिया के साथ परीक्षण करें
कोपायलट के पूरा होने के बाद, आप अपने हितधारकों के साक्षात्कारों से प्राप्त वास्तविक प्रतिक्रिया के साथ आउटपुट का परीक्षण कर सकते हैं।
- अपने सहेजे गए डेटा से किसी हितधारक की प्रतिक्रिया को कॉपी करें।
- इसे सेंटीमेंट एनालाइजर से चलाकर देखें।
- सच में, भावना आपकी अपेक्षा के अनुरूप है।
ऐप को एपीआई प्रतिक्रिया को "सकारात्मक", "नकारात्मक" या "तटस्थ" के रूप में एक आत्मविश्वास स्कोर के साथ दिखाना चाहिए।
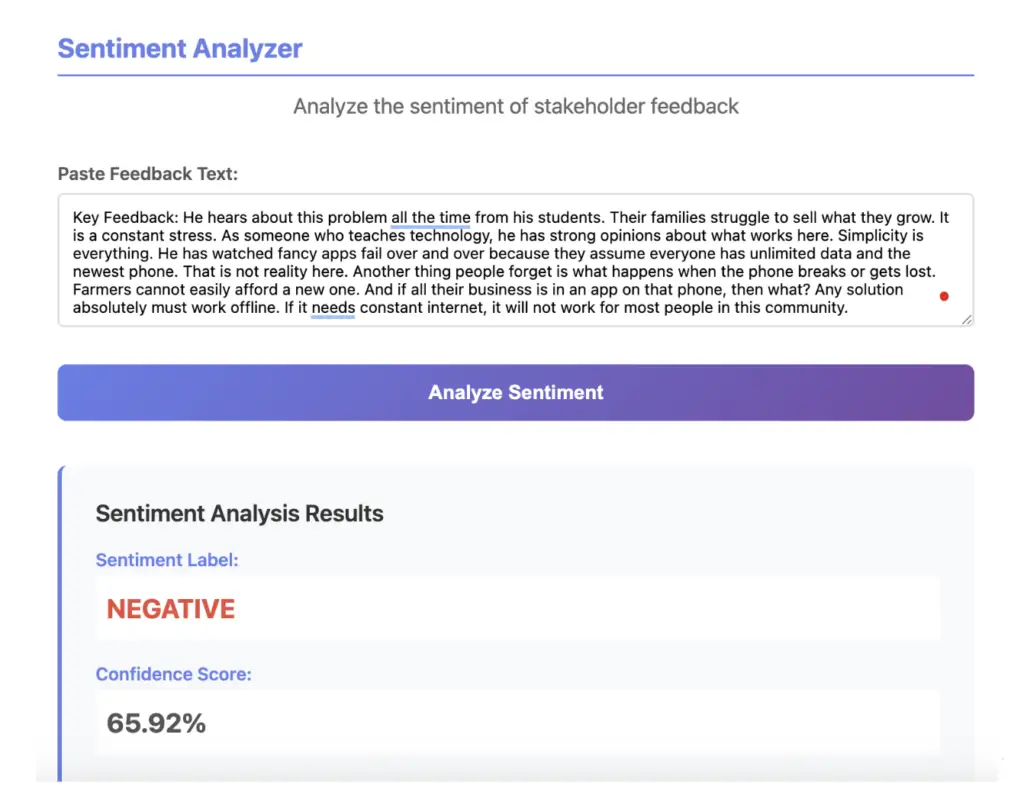
- यदि आपको कोई त्रुटि आती है, तो कोपायलट या किसी बाहरी एलएलएम (चैटजीपीटी हगिंग फेस एपीआई समस्याओं का निदान करने में माहिर है) से सहायता लें। यहां कुछ संभावित समस्याएं दी गई हैं।
- API से त्रुटि मिली: मॉडल लोड होने में समस्या हो सकती है या प्रमाणीकरण में समस्या आ सकती है। 20-30 सेकंड प्रतीक्षा करें और पुनः प्रयास करें या अपनी API सेटिंग्स की जाँच करें।
- भावनात्मक लेबल मेल नहीं खाते: तटस्थ पाठ को वर्गीकृत करना कठिन है। अधिक राय-आधारित उदाहरणों का प्रयास करें।
इस मॉडल के उपयोग के बारे में अधिक जानकारी के लिए, उनका आधिकारिक दस्तावेज़ यहाँ पाया जा सकता है: https://huggingface.co/cardiffnlp/twitter-roberta-base-sentiment-latest
7. अपने बदलावों को कमिट, पुश और मर्ज करें
- अपने कोडस्पेस में अपने बदलावों को कमिट करें।
- GitHub पर जाएं, एक पुल रिक्वेस्ट बनाएं और बदलावों को मुख्य ब्रांच में मर्ज करें।
- आप अपनी ब्रांच को डिलीट कर सकते हैं, लेकिन अपना कोडस्पेस रख सकते हैं।
अपने स्वयं के मॉडल को प्रशिक्षित करना और उसका उपयोग करना
इस एक्सेलेरेटर में भाग लेने वाले अधिकांश प्रतिभागियों को अपना मॉडल बनाने की आवश्यकता नहीं होगी। कई मॉडल पहले से ही मौजूद हैं और उपलब्ध हैं, जो अधिकांश समस्याओं के समाधान में काम आ सकते हैं। हालांकि, यदि आपका समाधान किसी विशेष समस्या के वर्गीकरण या पूर्वानुमान पर आधारित है - उदाहरण के लिए, किसी ऐसे पौधे की पहचान करना जो केवल आपके क्षेत्र में ही पाया जाता है - तो आपको एक डेटासेट एकत्र करना होगा और उसका उपयोग करके एक मशीन लर्निंग मॉडल को प्रशिक्षित करना होगा जिसे आप अपने समाधान में लागू कर सकते हैं।
नीचे दिए गए चैलेंज में, आप फाउंडर्स टूलकिट ऐप के उदाहरण के साथ पूरी प्रक्रिया का पालन करेंगे।
- एक सरल डेटासेट को साफ़ करें
- हगिंग फेस के ऑटोट्रेन और एक स्थानीय डेटासेट का उपयोग करके एक भावना वर्गीकारक को प्रशिक्षित करें
- स्टेकहोल्डर फीडबैक पर भावना का वर्गीकरण करने के लिए अपने फाउंडर्स टूलकिट में दिए गए मॉडल का उपयोग करें। यह अपने आप में एक बहु-चरणीय प्रक्रिया है।
- एक गले लगने वाले चेहरे का ग्रेडियो स्पेस बनाएं
- अपने स्पेस में अपने मॉडल का एक सरल डेमो (इनपुट -> आउटपुट) बनाएं।
- Space ऐप Python में चलता है और हम अपने React ऐप में @gradio/client SDK का उपयोग करके इन दोनों के बीच संबंध स्थापित करते हैं।
- मॉडल तक पहुंचने और पूर्वानुमान परिणामों को प्रदर्शित करने के लिए फाउंडर्स टूलकिट में ग्रैडियो क्लाइंट कनेक्शन कोड जोड़ें।
यह संपूर्ण मशीन लर्निंग कार्यप्रणाली को सिखाता है:
डेटा → प्रशिक्षण → मूल्यांकन → तैनाती
गतिविधि 3सी
एआई पथ - भविष्यसूचक - अपना खुद का मॉडल प्रशिक्षित करना
अनुमानित समय: 60-90 मिनट
यदि आपने अपनी वर्कशीट में प्रेडिक्टिव एआई पाथ चुना है और आपके पास अपना डेटा है, तो इस गतिविधि को पूरा करें।
इस चुनौती में, हम हगिंग फेस के ऑटोट्रेन का उपयोग करके अपना खुद का सेंटीमेंट क्लासिफायर प्रशिक्षित करेंगे।
1. हगिंग फेस अकाउंट बनाएं और एपीआई टोकन बनाएं।
यदि आपने गतिविधि 3B पूरी कर ली है, तो संभवतः आपने यह पहले ही कर लिया होगा। यदि नहीं, तो नीचे दिए गए चरणों का पालन करें।
- huggingface.co पर जाएं और एक निःशुल्क खाता बनाएं (यदि आपके पास पहले से कोई खाता नहीं है)।
- अपनी प्रोफ़ाइल पर क्लिक करें → सेटिंग्स → एक्सेस टोकन
- नया टोकन बनाने के लिए क्लिक करें, टोकन प्रकार "रीड" चुनें और इसे एक उपयुक्त नाम दें।
- टोकन का मान कॉपी करें और इसे सुरक्षित रूप से सहेजें।
2. डेटासेट को साफ़ करने का अभ्यास करें
इस गतिविधि के लिए, हम HuggingFace से उपलब्ध एक बड़े डेटासेट का उपयोग करेंगे। हालांकि, जब आप अपने स्वयं के प्रोजेक्ट पर काम कर रहे होंगे, तो संभवतः आप अपने स्वयं के डेटा का उपयोग करेंगे। ये चरण आपको बेहतर मॉडल के लिए "साफ़-सुथरा" डेटा सुनिश्चित करने के कुछ बुनियादी तरीके दिखाएंगे।
- अपने कंप्यूटर पर एक फोल्डर बनाएं और उसका नाम sentiment-analysis रखें ।
- इस गूगल शीट को खोलें और इसमें मौजूद डेटा को देखें।
- क्या आपको कोई समस्या दिखाई दे रही है?
- डेटा के खाली होने या गायब होने, डुप्लिकेट आईडी और असंगत लेबल की जांच करें।
- इस फ़ाइल को .csv (कॉमा सेपरेटेड वैल्यूज़) फॉर्मेट में sentiment-analysis फोल्डर में डाउनलोड करें। इसका नाम raw_data.csv रखें ।
- उसी फ़ोल्डर में, (मैक पर TextEdit या विंडोज पर Notepad का उपयोग करके) एक नई फ़ाइल बनाएं।
- नीचे दिए गए कोड को पेस्ट करें और फ़ाइल को clean_data.py के रूप में सहेजें।
					import pandas as pd

# ---------- CONFIG ----------
INPUT_FILE = "raw_data.csv"
OUTPUT_FILE = "clean_data.csv"

# ---------- LOAD DATA ----------
df = pd.read_csv(INPUT_FILE)

# ---------- CLEANING STEPS ----------

# 1. Remove rows with missing values
df = df.dropna()

# 2. Remove duplicates
df = df.drop_duplicates()

# 3. Remove irrelevant columns (optional)
# Example: keep only "text" and "label" columns
df = df[["text", "label"]]

# 4. Basic formatting
df["text"] = df["text"].str.strip()     # remove extra spaces
df["text"] = df["text"].str.replace("\n", " ", regex=False)  # remove newlines

# 5. Save cleaned file
df.to_csv(OUTPUT_FILE, index=False)
print(f"Cleaned data saved to {OUTPUT_FILE}")
- कोड को देखें और समझें कि डेटा को साफ करने के लिए प्रत्येक चरण क्या कर रहा है।
- अपने कंप्यूटर पर एक टर्मिनल विंडो खोलें (कोडस्पेस में नहीं)।
- यह जांचने के लिए कि आपके सिस्टम में पायथन इंस्टॉल है या नहीं, python –version टाइप करें।
- यदि आपके कंप्यूटर में पायथन इंस्टॉल नहीं है, तो यहां जाएं और इसे डाउनलोड और इंस्टॉल करें।
- टर्मिनल विंडो में cd कमांड का उपयोग करके सेंटीमेंट-एनालिसिस फोल्डर पर जाएं। यदि आपको सहायता की आवश्यकता हो तो ऑनलाइन सहायता प्राप्त करें।
- एक बार जब आप सेंटीमेंट-एनालिसिस फ़ोल्डर में पहुँच जाएँ, तो pip install pandas टाइप करें (या यदि pip को पहचानता नहीं है तो pip3 install pandas टाइप करें )। इससे पांडा लाइब्रेरी, जो कि पायथन डेटा विश्लेषण लाइब्रेरी है, इंस्टॉल हो जाएगी।
- एक बार इंस्टॉल हो जाने के बाद, python clean_data.py या python3 clean_data.py टाइप करें (यह इस बात पर निर्भर करता है कि आपके सिस्टम में पायथन का कौन सा संस्करण इंस्टॉल है)। इससे आपके द्वारा बनाई गई पायथन फ़ाइल का कोड निष्पादित हो जाएगा।
- "साफ़ किया गया डेटा clean_data.csv में सहेजा गया" संदेश आने तक प्रतीक्षा करें और फिर clean_data.csv फ़ाइल को ढूंढें और उसे टेक्स्ट एडिटर या एक्सेल में खोलें।
- फाइल में हुए बदलावों पर ध्यान दें। गुम डेटा, डुप्लिकेट और गलत लेबल को ठीक किया जाना चाहिए।
यह सिर्फ आपको अपना डेटा साफ करने के तरीके दिखाने के लिए एक अभ्यास है। गतिविधि के शेष भाग के लिए, हम HuggingFace से डाउनलोड किए गए एक बहुत बड़े डेटासेट का उपयोग करेंगे।
3. टेक्स्ट डेटासेट डाउनलोड करें
अपने स्वयं के डेटासेट का उपयोग करके अनुकरण करने के लिए, हम हगिंग फेस से एक बड़ा डेटासेट CSV फ़ाइलों के रूप में डाउनलोड करेंगे, जिसका उपयोग आप हगिंग फेस ऑटोट्रेन का उपयोग करके एक मॉडल को प्रशिक्षित करने के लिए करेंगे। ऑटोट्रेन अत्याधुनिक मशीन लर्निंग मॉडल को प्रशिक्षित और तैनात करने का एक स्वचालित (और कम/बिना लागत वाला) तरीका है, जो हगिंग फेस इकोसिस्टम के साथ सहज रूप से एकीकृत है।
- हगिंग फेस डेटासेट पर जाएं ।
- डेटासेट के आगे, जहां फ़िल्टर बाय नेम लिखा है, वहां syedkhalid076 / Sentiment-Analysis टाइप करें ।
हम इस डेटासेट का उपयोग करेंगे क्योंकि यह बड़ा है, और इसमें वही लेबल हैं जो हम अपने फाउंडर्स टूलकिट के लिए चाहते हैं, यानी नकारात्मक, तटस्थ और सकारात्मक।
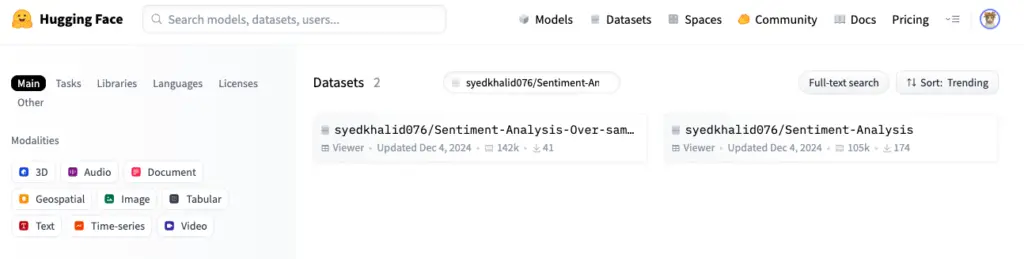
- आपको दो डेटासेट दिखाई देंगे। दूसरे डेटासेट पर क्लिक करें और डेटासेट कार्ड को देखकर उसके बारे में जानें और कुछ नमूना डेटा देखें।
- डेटासेट से संबंधित फाइलों को देखने के लिए "फाइलें और संस्करण" पर क्लिक करें।
- हमें प्रशिक्षण और सत्यापन डेटा की आवश्यकता होगी, इसलिए train_data.csv और val_data.csv डाउनलोड करने के लिए क्लिक करें।
- दोनों फाइलों को अपने सेंटीमेंट-एनालिसिस फोल्डर में ले जाएं। डेटा कैसा दिखता है, यह देखने के लिए उन्हें खोलें।
- ऑटोट्रेन को डेटा फ़ाइलों के लिए विशिष्ट नामों की आवश्यकता होती है। train_data.csv का नाम बदलकर train.csv और val_data.csv का नाम बदलकर valid.csv कर दें।
4. अपने मॉडल को प्रशिक्षित करने के लिए Google Colab सेटअप करें।
आप HuggingFace AutoTrain Spaces का उपयोग करके सीधे उनके प्लेटफॉर्म पर प्रशिक्षण देने का प्रयास कर सकते हैं, लेकिन यह प्लेटफॉर्म कुछ समस्याओं से ग्रस्त हो सकता है, खासकर यदि आप निःशुल्क संस्करण का उपयोग कर रहे हैं। AutoTrain इंस्टॉल करके आप इसे अपने कंप्यूटर पर स्थानीय रूप से भी प्रशिक्षित कर सकते हैं, लेकिन इसके लिए एक अच्छे कंप्यूटर की आवश्यकता होगी जिसमें पर्याप्त CPU क्षमता हो। स्थानीय स्तर पर किसी भी समस्या से बचने के लिए, हम Google Colab की सहायता लेंगे, जो आपको Colab नोटबुक बनाने और Google GPU की शक्ति का लाभ उठाते हुए क्लाउड में Python कोड चलाने की सुविधा देता है।
- ऑटोट्रेन एडवांस्ड के लिए इस गिटहब रिपॉजिटरी पर जाएं।
- README फ़ाइल को नीचे स्क्रॉल करें और समर्थित कार्यों के अंतर्गत टेक्स्ट वर्गीकरण खोजें ।
- कोलाब में खोलने के लिए टेक्स्ट क्लासिफिकेशन लिंक पर क्लिक करें।
- एक Google Colab नोटबुक खुल जाएगी। इसकी एक कॉपी अपने Google Drive में सेव करने के लिए 'कॉपी टू ड्राइव' पर क्लिक करें।
- सबसे ऊपर, नोटबुक का नाम बदलकर sentiment-analysis-model.ipynb कर दें।
- ऊपर स्थित रनटाइम मेनू पर क्लिक करें और रनटाइम प्रकार बदलें चुनें।
- T4 GPU चुनें और सेव पर क्लिक करें। हो सकता है यह आपको लैपटॉप रीस्टार्ट करने के लिए कहे। ऐसा करने के लिए कहें। इससे आपको ट्रेनिंग में तेज़ी लाने के लिए GPU की शक्ति मिलेगी।
5. अपने डेटासेट को अपने कोलाब नोटबुक में कॉपी करें
- बाईं ओर के आइकन मेनू में, फ़ाइल मैनेजर खोलने के लिए फ़ोल्डर आइकन पर क्लिक करें। आपको sample_data नाम का एक फ़ोल्डर दिखाई देगा । उस पर क्लिक करें और उसका नाम बदलकर data कर दें ।
- फोल्डर खोलें। आपको कई CSV और JSON फाइलें दिखाई देंगी।
- HuggingFace से डाउनलोड की गई train.csv और valid.csv फ़ाइलों को फ़ोल्डर में ड्रैग करें।
6. मॉडल को प्रशिक्षित करने के लिए अपना कोलाब नोटबुक सेट अप करें।
हालांकि आपको कुछ सैंपल कोड दिया गया है, लेकिन आपको अपने डेटा और मॉडल के लिए कॉन्फ़िगरेशन में कुछ अपडेट करने होंगे।
- पहले दो टेक्स्ट/कोड ब्लॉक (जिन्हें सेल कहा जाता है) के बीच में माउस ले जाएं। आपको +कोड और +टेक्स्ट बटन दिखाई देंगे। एक खाली कोड सेल बनाने के लिए +कोड पर क्लिक करें।
- सेल में !pip install autotrain-advanced टाइप करें ।
इससे आपके नोटबुक में autotrain-advanced पैकेज इंस्टॉल हो जाएगा। कमांड के आगे लगा ! का मतलब है नोटबुक के अंदर से टर्मिनल कमांड चलाना। - सेल के बाईं ओर स्थित तीर पर क्लिक करके सेल के अंदर के कमांड चलाएँ। ऑटोट्रेन-एडवांस्ड पैकेज के इंस्टॉल होने तक प्रतीक्षा करें।
- उन लाइब्रेरी को आयात करने के लिए नीचे दिए गए अगले सेल में तीर पर क्लिक करें।
- अगले सेल में, हमें HuggingFace के लिए अपना यूज़रनेम और पासवर्ड सेट करना होगा। your_huggingface_username की जगह अपना HuggingFace का असली यूज़रनेम डालें।
- अपने टोकन को सीधे नोटबुक में टाइप करने के बजाय, आइए इसे छिपाकर अधिक सुरक्षित रहें। इसे बदलें
HF_TOKEN = “your_huggingface_write_token” लाइन के साथ
HF_TOKEN = getpass(“अपना HF टोकन दर्ज करें: “) - तीर पर क्लिक करके सेल कोड चलाएं। यह आपको अपना हगिंग फेस टोकन दर्ज करने के लिए कहेगा। पूछे जाने पर टोकन को कॉपी और पेस्ट करें।
टोकन छिपा रहता है, लेकिन यदि आप अपना नोटबुक बंद करके दोबारा खोलते हैं तो इसे फिर से दर्ज करना होगा।
7. प्रशिक्षण के लिए पैरामीटर अपडेट करें
यह कोड उपलब्ध है। अधिकांश डिफ़ॉल्ट सेटिंग्स हमारे लिए काम करेंगी, लेकिन हमें कुछ चीजें बदलनी होंगी।
					params = TextClassificationParams(
   model="google-bert/bert-base-uncased",
   data_path="stanfordnlp/imdb", # path to the dataset on huggingface hub
   text_column="text", # the column in the dataset that contains the text
   target_column="label", # the column in the dataset that contains the labels
   train_split="train",
   valid_split="test",
   epochs=3,
   batch_size=8,
   max_seq_length=512,
   lr=1e-5,
   optimizer="adamw_torch",
   scheduler="linear",
   gradient_accumulation=1,
   mixed_precision="fp16",
   project_name="autotrain-model",
   log="tensorboard",
   push_to_hub=True,
   username=HF_USERNAME,
   token=HF_TOKEN,
)
- data_path वर्तमान में Hugging Face पर मौजूद एक डेटासेट को संदर्भित करता है। हम अपने "स्थानीय" CSV फ़ाइलों को इंगित करना चाहते हैं। इसलिए, पथ को "data" पर सेट करें ।
- data_path लाइन के नीचे 2 लाइनें जोड़ें।
ट्रेन_स्प्लिट="ट्रेन",
वैध_विभाजन="वैध",
यह प्रशिक्षण और सत्यापन डेटा के लिए हमारी 2 .csv फाइलों की ओर इशारा करता है। - text_column और target_column हमारे .csv फ़ाइलों में मौजूद डेटा से मेल खाते हैं। इसलिए इन्हें यथावत रखें।
- project_name को किसी उपयुक्त नाम में बदलें, जैसे sentiment-analysis-model ।
- बाकी सभी पैरामीटर ठीक हैं। सेल को चलाने के लिए तीर पर क्लिक करें।
- अगले सेल को छोड़ दें। यह केवल सूचनात्मक है।
- इस कोड वाले सेल को चलाएं:
प्रोजेक्ट = ऑटोट्रेनप्रोजेक्ट (पैरामीटर = पैरामीटर, बैकएंड = "लोकल", प्रोसेस = ट्रू)
प्रोजेक्ट.क्रिएट() .
इससे मॉडल को प्रशिक्षित करना शुरू हो जाएगा।
धैर्य रखें और अपनी मशीन पर विंडो खुली रखें ।
मॉडल को प्रशिक्षित करने में 30 मिनट से लेकर एक घंटे से अधिक समय लग सकता है।
8. गले लगाते हुए चेहरे पर अपने मॉडल का पता लगाएं
- मॉडल की ट्रेनिंग पूरी होने के बाद, अपने हगिंग फेस अकाउंट में जाएं और अपनी प्रोफ़ाइल पर क्लिक करें। आपको एक नया मॉडल मिल जाएगा जिसका नाम वही होगा जो आपने कोलाब नोटबुक में दिया था।
- मॉडल मिल जाने के बाद, उसे खोलने के लिए नाम पर क्लिक करें।
- सेटिंग्स पर क्लिक करें और इसे सार्वजनिक करें। इससे आपके मॉडल के लिए पाइपलाइन बनाते समय यह आसानी से उपलब्ध हो जाएगा।
9. गले लगाने के लिए एक नया स्थान बनाएं
- हगिंग स्पेस विंडो के शीर्ष पर, स्पेसेस पर क्लिक करें।
- + नया स्थान बटन पर क्लिक करें ।
- अपने स्पेस को एक उपयुक्त नाम दें, जैसे कि founders-toolkit-sentiment-analysis।
- स्पेस एसडीके के लिए, ग्रेडियो चुनें, और स्पेस हार्डवेयर के लिए, सीपीयू बेसिक चुनें।
- सुनिश्चित करें कि आपका स्पेस पब्लिक पर सेट है और स्पेस बनाएं।
- स्क्रीन के ऊपरी भाग में मौजूद "फ़ाइलें" पर क्लिक करें। इससे आपको अपने स्पेस में मौजूद फ़ाइलें दिखाई देंगी। ध्यान दें कि यह GitHub रिपॉज़िटरी की तरह दिखता है।
- आपको अपने मॉडल को चलाने के लिए फ़ाइलें जोड़नी होंगी। 'योगदान करें' पर क्लिक करें और एक नई फ़ाइल बनाएँ ।
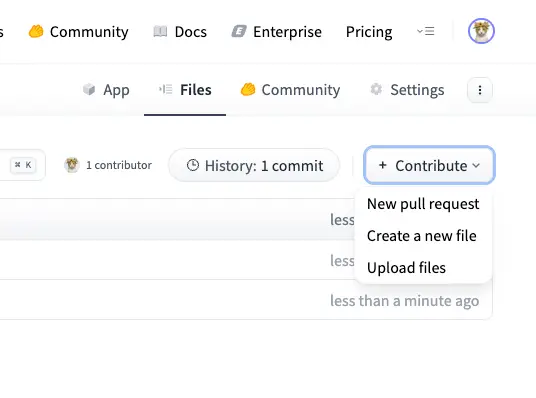
8. निम्नलिखित कोड पेस्ट करें:
					import gradio as gr
from transformers import pipeline


classifier = pipeline("text-classification",
 model="HF_USERNAME/HF_MODELNAME")


def predict(text):
   return classifier(text)


with gr.Blocks() as demo:
   text_input = gr.Textbox(label="Input Text")
   output = gr.JSON(label="Prediction")


   text_input.submit(predict, inputs=text_input, outputs=output)


demo.launch()
- कोड की उस पंक्ति में जहां model= लिखा है, वहां अपना Hugging Face यूजरनेम और मॉडल का नाम टाइप करें।
आप हगिंग फेस में अपनी प्रोफ़ाइल पर क्लिक करके और फिर मॉडल पर क्लिक करके यह जानकारी आसानी से प्राप्त कर सकते हैं। मॉडल पेज के शीर्ष पर आप अपना नाम/मॉडल कॉपी कर सकते हैं। - इस फ़ाइल का नाम app.py रखें।
- फ़ाइल सूची पर वापस जाने के लिए मुख्य शाखा के बगल में स्थित स्थान के नाम पर क्लिक करें। फिर से 'योगदान करें' पर क्लिक करें और एक नई फ़ाइल बनाएँ ।
यह आपकी requirements.txt फ़ाइल होगी, जो पायथन को बताती है कि स्पेस को चलाते समय किन लाइब्रेरी को लोड करना है। - पेस्ट:
ट्रान्सफ़ॉर्मर
मशाल
इसे requirements.txt नाम की फाइल में डालें।
10. अपना स्पेस शुरू करें
- स्क्रीन के ऊपरी भाग में स्थित ऐप पर क्लिक करें , और इससे ऐप/स्पेस शुरू हो जाएगा।
आपके ऐप को चलने में कुछ मिनट लग सकते हैं। अंत में, आपको स्क्रीन के शीर्ष पर एक हरा "चल रहा है" बटन दिखाई देगा। - आप इनपुट टेक्स्ट ब्लॉक में कुछ टाइप करके अपने मॉडल का परीक्षण कर सकते हैं और नीचे आपको पूर्वानुमान प्राप्त हो जाएगा।
ध्यान दें कि इसे चलाने पर आपको एक लेबल और एक स्कोर मिलता है। लेबल 0, 1 या 2 होता है। 0 का मतलब नकारात्मक, 1 का मतलब तटस्थ और 2 का मतलब सकारात्मक होता है। स्कोर भविष्यवाणी के प्रति विश्वास का स्तर बताता है। यह 0 से 1 के बीच होता है, जिसमें 1 का मतलब भविष्यवाणी पर पूर्ण विश्वास होता है।
11. संस्थापक के टूलकिट में जोड़ें
यह हिस्सा थोड़ा मुश्किल हो सकता है, लेकिन इसे लागू करने के लिए कोपायलट (या अन्य एलएलएम) के साथ काम करें।
- अपने GitHub रिपॉजिटरी पर एक नई ब्रांच खोलें।
- अपना GitHub कोडस्पेस खोलें।
- नई शाखा देखें।
- ग्रैडियो लाइब्रेरी को इंस्टॉल करने के लिए टर्मिनल विंडो में यह कमांड चलाएं।
npm install @gradio/client
- नीचे दिए गए प्रॉम्प्ट का उपयोग कोपायलट के साथ करें, और MY_HF_USERNAME और MY_HF_SPACE को हगिंग फेस पर अपने उपयोगकर्ता नाम और स्पेस से बदलें (ध्यान दें कि ये दो स्थानों पर दिखाई देते हैं)।
ऐप में "माई सेंटीमेंट एनालाइज़र" टैब जोड़ें। इसमें उपयोगकर्ता के इनपुट के लिए एक टेक्स्ट फ़ील्ड और "एनालाइज सेंटीमेंट" बटन होना चाहिए।
बटन दबाने से हगिंग फेस ग्रेडियो स्पेस MY_HF_USERNAME/MY_HF_SPACE (बिना बैकएंड के) पर कॉल शुरू हो जानी चाहिए।
ग्रेडियो स्पेस से प्राप्त प्रतिक्रिया में लेबल और स्कोर प्रदर्शित होने चाहिए।
प्रतिबंध:
- यह केवल क्लाइंट-आधारित एकीकरण है; server.js को संशोधित न करें या नए एंडपॉइंट न जोड़ें।
- jsdelivr से ESM के माध्यम से @gradio/client का उपयोग करें; सुनिश्चित करें कि केवल एक आयात पथ हो और window.GradioClient को उजागर करें।
- एकल CSP मेटा टैग में समेकित करें। अनुमति दें: connect-src 'self' https://generativelanguage.googleapis.com https://*.hf.space https://huggingface.co wss://*.hf.space; script-src 'unsafe-inline' https://cdn.jsdelivr.net; style-src 'unsafe-inline'.
- Client.connect('MY_HF_USERNAME/MY_HF_SPACE') और predict('/predict', [text]) के साथ स्पेस को कॉल करें।
आउटपुट मैपिंग:
- मानचित्र लेबल: 0 → नकारात्मक, 1 → तटस्थ, 2 → सकारात्मक
- स्कोर 0 से 1 के बीच होता है। इसे दो दशमलव स्थानों तक प्रतिशत के रूप में दर्शाएँ।
- कोपायलट द्वारा उपयुक्त कोड जनरेट करने के बाद ऐप का परीक्षण करें। सामने आने वाली किसी भी समस्या का समाधान करें। एक नकारात्मक टिप्पणी लिखकर परिणाम देखें, फिर एक सकारात्मक टिप्पणी लिखकर देखें।
12. अपने बदलावों को कमिट, पुश और मर्ज करें
जब आप परिणामों से संतुष्ट हो जाएं:
- अपने कोडस्पेस में अपने बदलावों को कमिट करें।
- GitHub पर जाएं, एक पुल रिक्वेस्ट बनाएं और बदलावों को मुख्य ब्रांच में मर्ज करें।
- आप अपनी ब्रांच को डिलीट कर सकते हैं, लेकिन अपना कोडस्पेस रख सकते हैं।
नोट: यह गतिविधि और हगिंग फेस स्पेसेस का उपयोग आपको एक कम या बिना लागत वाली विधि दिखाने के लिए है जिसका उपयोग आप अपने मॉडल को किसी ऐप में एकीकृत करने के लिए कर सकते हैं। हमने फ्रंटएंड और क्लाइंट कनेक्शन का उपयोग किया, और परीक्षण को सरल बनाने के लिए अपने मॉडल और हगिंग फेस स्पेस दोनों को सार्वजनिक रखा। हालांकि, यदि आप हगिंग फेस ऑटोट्रेन और स्पेसेस का उपयोग करके अपना मॉडल प्रशिक्षित कर रहे हैं, तो ध्यान रखें कि आपको बैकएंड सर्वर ( server.js ) का उपयोग करके और .env का उपयोग करके अपने टोकन को सुरक्षित करके अधिक सुरक्षा सुनिश्चित करनी होगी।
प्रतिबिंब
आपने तकनीकी स्टैक और एआई पाथ के बारे में सीखा और अपने उत्पाद से संबंधित कुछ निर्णय लिए। यहां कुछ बातें हैं जिन पर विचार करना चाहिए:
तकनीकी स्टैक
एआई पथ
व्यापार नापसंद
पिचिंग
महत्वपूर्ण पदों
- टेक स्टैक: आपके ऐप को बनाने के लिए उपयोग की जाने वाली प्रोग्रामिंग भाषाओं, फ्रेमवर्क और सेवाओं का संयोजन।
- फ्रंटएंड: उपयोगकर्ता जो देखते हैं और जिसके साथ इंटरैक्ट करते हैं (HTML, CSS, JavaScript, React)
- बैकएंड: सर्वर-साइड कोड जो डेटा को प्रोसेस करता है और लॉजिक को चलाता है
- एपीआई (एप्लिकेशन प्रोग्रामिंग इंटरफ़ेस): आपके कोड के लिए बाहरी सेवाओं के साथ संवाद करने का एक तरीका।
- एलएलएम (लार्ज लैंग्वेज मॉडल): एक कृत्रिम बुद्धिमत्ता जो टेक्स्ट उत्पन्न करती है, बातचीत करती है और दस्तावेज़ों का विश्लेषण करती है।
- भविष्यवाणीत्मक एआई: वह एआई जो भविष्यवाणियां या वर्गीकरण करने के लिए डेटा में पैटर्न ढूंढता है।
- तापमान (एआई सेटिंग): यह नियंत्रित करता है कि एआई प्रतिक्रियाएं कितनी रचनात्मक और कितनी सुसंगत हैं (0 = अनुमानित, 1 = रचनात्मक)
- निष्कर्ष: प्रशिक्षित मॉडल का उपयोग करके नए डेटा पर भविष्यवाणियां करना
- प्रशिक्षण: लेबल किए गए उदाहरण दिखाकर मॉडल को पैटर्न पहचानने का प्रशिक्षण देना।
- पूर्व-प्रशिक्षित मॉडल: एक ऐसा मॉडल जिसे पहले से ही बड़े डेटासेट पर प्रशिक्षित किया गया है और जो उपयोग के लिए तैयार है।
- ऑटोट्रेन: एक ऐसा प्लेटफॉर्म जो बिना कोडिंग के मशीन लर्निंग मॉडल को स्वचालित रूप से प्रशिक्षित करता है।
अतिरिक्त संसाधन
- गूगल एआई स्टूडियो – त्वरित प्रोटोटाइप के लिए बिल्ड मोड
- वर्गीकरण | मशीन लर्निंग | गूगल फॉर डेवलपर्स
- भावना विश्लेषण | क्लाउड प्राकृतिक भाषा एपीआई
- टोकन को समझें और गिनें | जेमिनी एपीआई | डेवलपर्स के लिए गूगल एआई
- Gradio JS क्लाइंट दस्तावेज़ीकरण
- हगिंग फेस ऑटोट्रेन – बिना कोड के मॉडल प्रशिक्षण
- ट्विटर सेंटीमेंट डेटासेट – गतिविधि 3b में प्रयुक्त डेटासेट
- हगिंग फेस इन्फरेंस एपीआई – एपीआई के माध्यम से मॉडल को कैसे कॉल करें
- ट्विटर पर भावना विश्लेषण ट्यूटोरियल – कोड उदाहरणों सहित विस्तृत ट्यूटोरियल